Sistema de Predicción de Enfermedades Cardíacas
Pipeline completo de machine learning para predecir riesgo cardíaco usando XGBoost, con despliegue en Docker y versionado de modelos
Tecnologías
Descripción
Implementación completa de machine learning con procesamiento robusto de datos y gestión de modelos. Características principales:
-
Pipeline automatizado de datos que maneja valores faltantes y escalado de características
-
División estratificada de datos con balanceo de clases
-
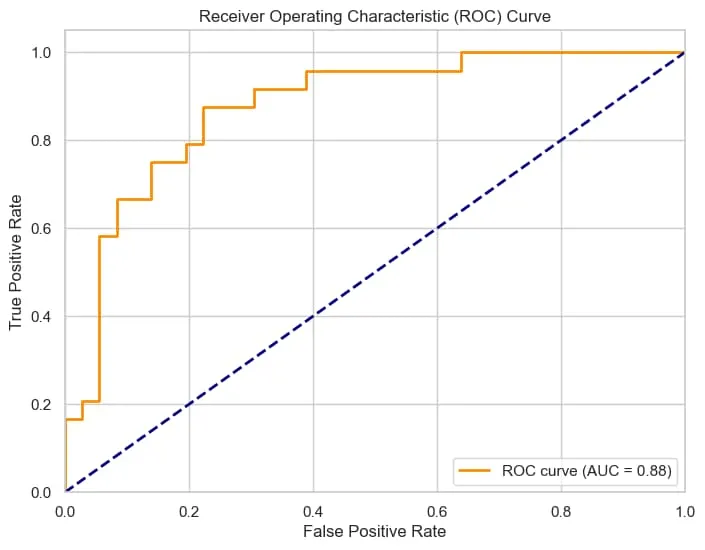
Seguimiento de rendimiento del modelo (Precisión, Recall, AUC-ROC)
-
Despliegue Dockerizado con gestión de dependencias Poetry
-
Versionado automático de modelos con serialización timestamp
-
Métricas de evaluación comprehensivas y reproductibilidad
Detalles Técnicos
A diferencia de un análisis exploratorio en notebook, este proyecto está organizado como un pipeline de producción: cada etapa (carga, procesamiento, entrenamiento, evaluación, guardado) vive en su propio módulo con una única responsabilidad, siguiendo el principio de separación de responsabilidades. Esto facilita testear cada parte de forma aislada, reemplazar componentes sin romper el resto, y containerizar todo el flujo con Docker para un despliegue reproducible.
src/data/data_loader.py
El primer módulo es deliberadamente simple: una única función responsable de leer el CSV crudo. Puede parecer trivial, pero separar la carga de datos en su propia función (en vez de tener un pd.read_csv suelto en el script principal) es lo que permite, más adelante, cambiar la fuente de datos (por ejemplo, leer desde una base de datos en vez de un CSV) sin tocar el resto del pipeline.
import pandas as pd

def load_data(file_path: str) -> pd.DataFrame:
    """
    Carga los datos desde un archivo CSV.

    Args:
        file_path (str): Ruta del archivo CSV.

    Returns:
        pd.DataFrame: DataFrame con los datos cargados.
    """
    return pd.read_csv(file_path)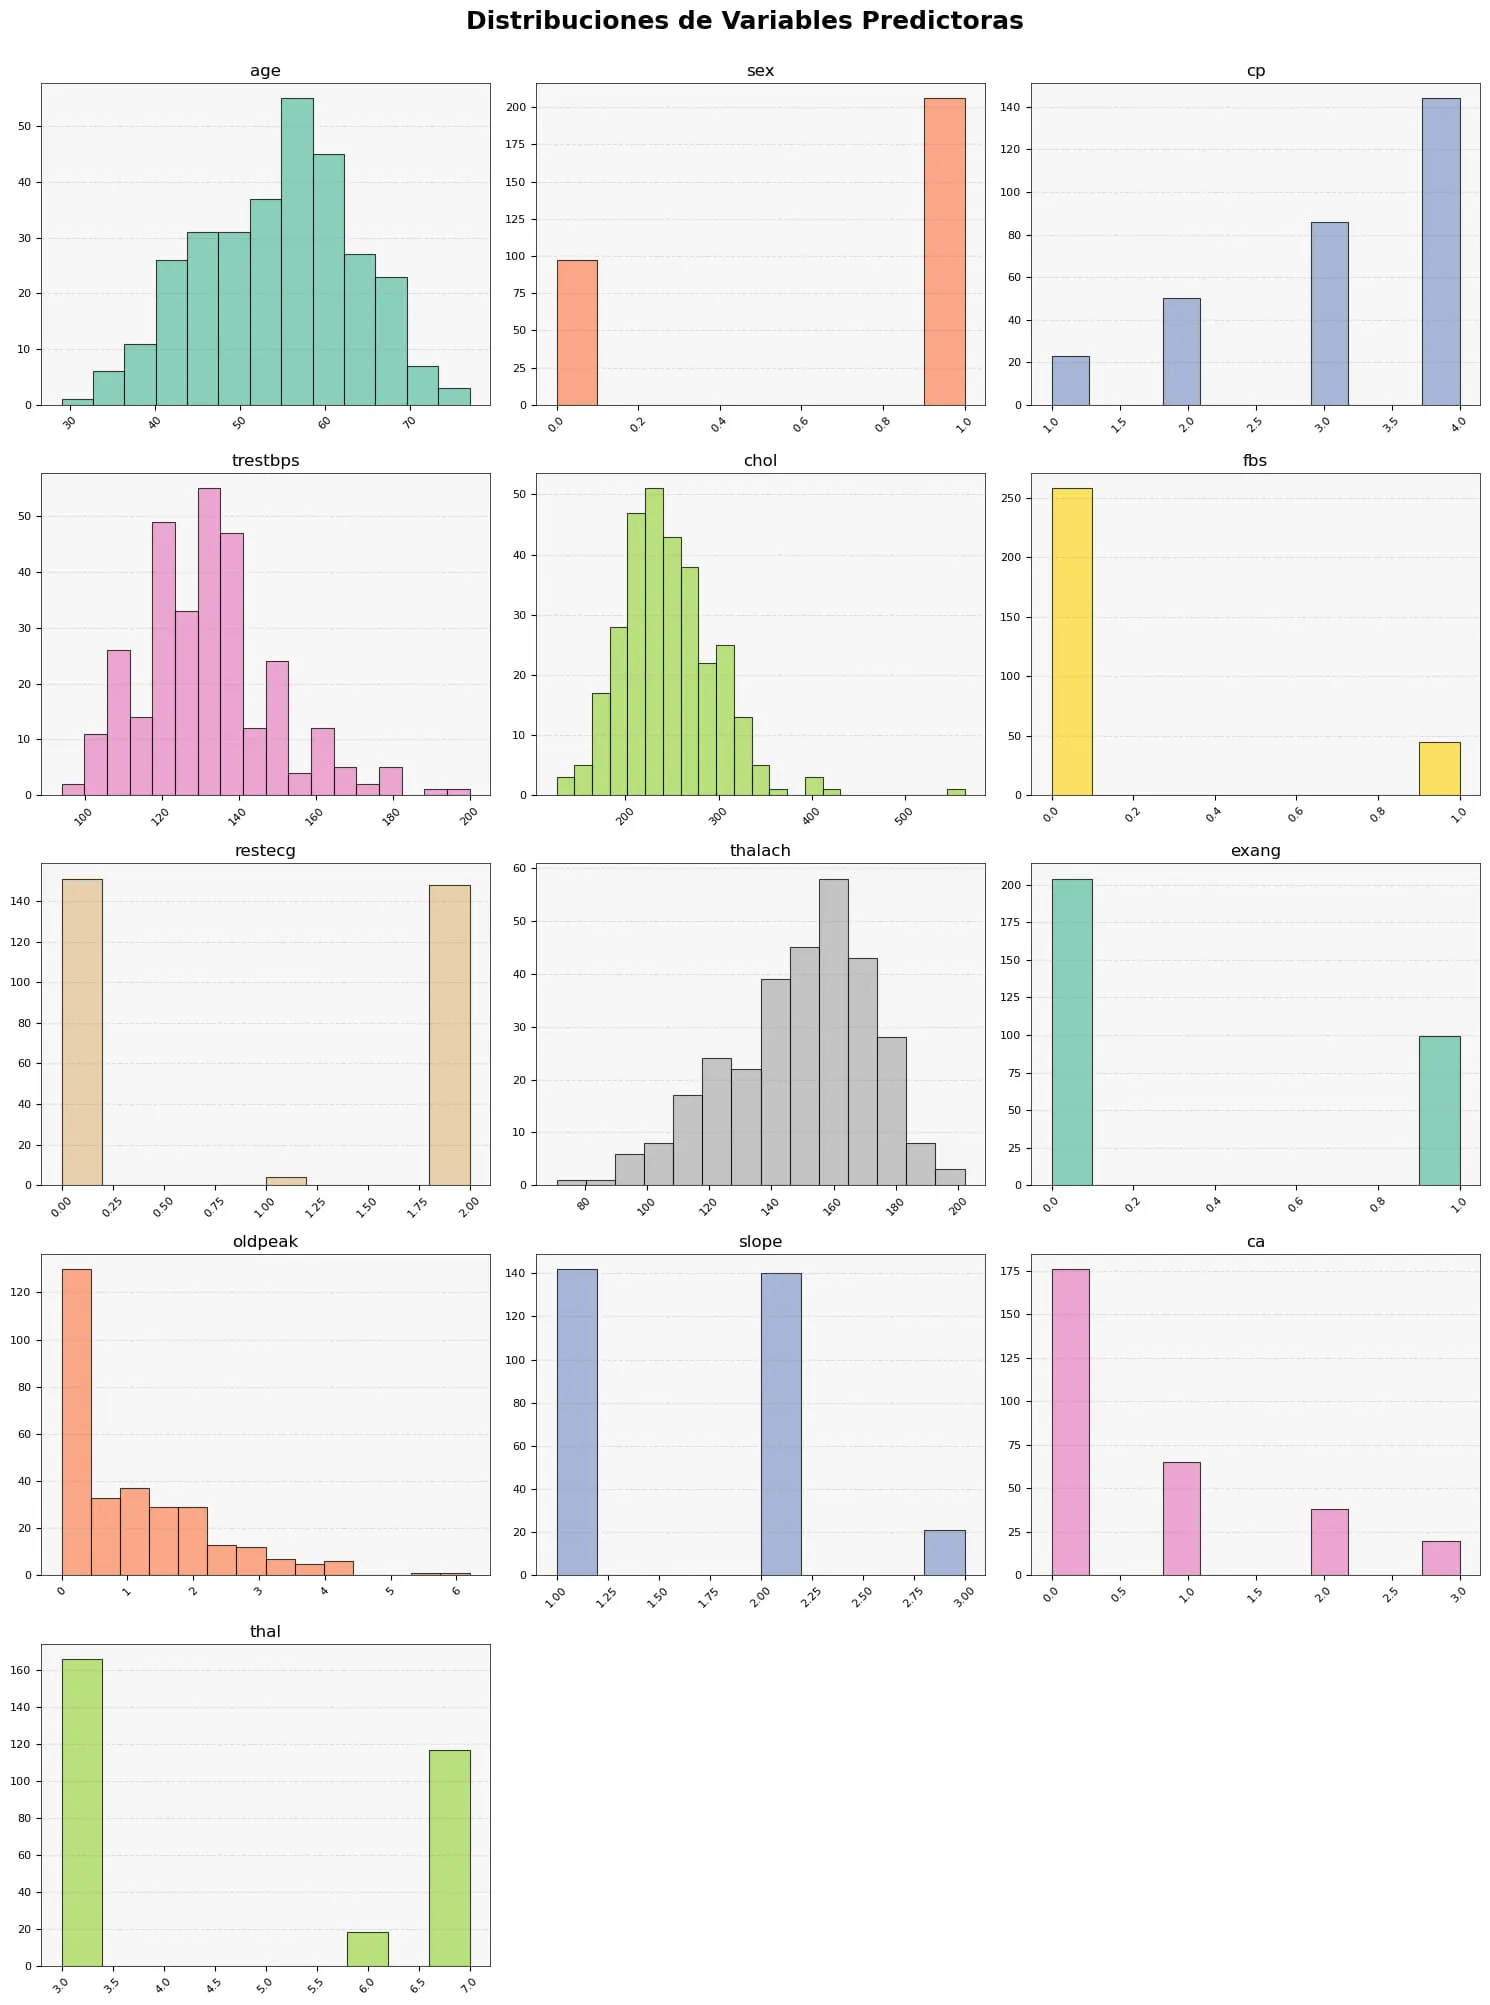
src/data/data_processor.py
Acá arranca la limpieza real de los datos. El dataset de UCI Heart Disease tiene una particularidad conocida: varias variables clínicas (presión arterial, colesterol, frecuencia cardíaca máxima, depresión del ST) usan el valor 0 para representar un dato faltante, no un valor real —un colesterol de 0 no tiene sentido fisiológico—. Por eso el primer paso es reemplazar esos ceros por NaN en las columnas relevantes, para que después puedan tratarse correctamente como valores faltantes (y no arrastrar ceros falsos que distorsionarían el entrenamiento del modelo).
La función también separa la variable objetivo (target_column) del resto de las features, dejando todo listo para la siguiente etapa: la división en train/test.
import pandas as pd
import numpy as np

def process_data(df: pd.DataFrame, columns_to_impute: list, target_column: str = None) -> tuple[pd.DataFrame, pd.Series]:
    """
    Procesa los datos:
    - Imputa los valores faltantes
    - Escalar las variables numéricas

    Args:
       df (pd.DataFrame): DataFrame con los datos a procesar.
       columns_to_impute (list): Lista de columnas a imputar los valores faltantes.
       target_column (str, optional): Nombre de la columna objetivo.

    Returns:
       pd.DataFrame: DataFrame con los datos procesados.
       pd.Series: Serie con la variable objetivo.
    """
    # Reemplazar valores 0 por NaN en las columnas a imputar
    df[columns_to_impute] = df[columns_to_impute].replace(0, np.nan)

    # Extraer la columna objetivo si es proporcionada
    target = df[target_column] if target_column else None

    return df, target
src/data/data_splitter.py
Este módulo divide el dataset en conjuntos de entrenamiento y prueba usando train_test_split de scikit-learn, con stratify=y activado por defecto. La estratificación es importante acá porque en datasets médicos las clases suelen estar desbalanceadas (menos casos positivos que negativos); estratificar asegura que la proporción de pacientes con y sin enfermedad cardíaca se mantenga similar tanto en train como en test, evitando que por azar el conjunto de prueba quede con muy pocos casos positivos para evaluar bien el modelo.
from sklearn.model_selection import train_test_split
import pandas as pd

def split_data(data: pd.DataFrame, target_column: str, test_size=0.2, random_state=42, stratify: bool = True) -> tuple[pd.DataFrame, pd.DataFrame, pd.Series, pd.Series]:
    """
    Dividir los datos en conjuntos de entrenamiento y prueba

    Args:
        data (pd.DataFrame): Dataframe que contiene los datos a dividir
        target_column (str): Nombre de la columna objetivo
        test_size (float, optional): Proporción de los datos que quedan en el test. Defaults to 0.2.
        random_state (int, optional): Semilla para la aleatoriedad. Defaults to 42.

    Returns:
        Tupla: Una tupla que contiene los conjuntos de entrenamiento y prueba
        - X_train (pd.DataFrame): Conjunto de entrenamiento de las variables independientes
        - X_test (pd.DataFrame): Conjunto de prueba de las variables independientes
        - y_train (pd.Series): Conjunto de entrenamiento de la variable objetivo
        - y_test (pd.Series): Conjunto de prueba de la variable objetivo
    """
    X = data.drop(columns=target_column, axis=1)
    y = data[target_column]

    # Dividir el conjunto de datos en entrenamiento y prueba
    if stratify:
        X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=test_size, random_state=random_state, stratify=y)
    else:
        X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=test_size, random_state=random_state)

    return X_train, X_test, y_train, y_test
src/main.py
Este es el punto de entrada que orquesta todo el pipeline de punta a punta: carga los datos crudos, los limpia, los divide en train/test, entrena el modelo, lo evalúa y lo guarda — todo llamando a los módulos anteriores en secuencia, sin repetir lógica. Un detalle relevante: la columna objetivo original (num) del dataset UCI no es binaria, sino que va de 0 (sin enfermedad) a 4 (distintos grados de severidad); acá se binariza (y > 0) porque el objetivo del modelo es un caso de uso más simple y accionable: predecir presencia o ausencia de enfermedad cardíaca, no su severidad. Al final se imprimen las métricas clave del modelo entrenado.
import sys
import os
# Agregar la raíz del proyecto al PYTHONPATH
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), "..")))
from src.data.data_loader import load_data
from src.data.data_processor import process_data
import pandas as pd
from src.data.data_splitter import split_data
from src.model.trainer import train_model
from src.model.evaluator import evaluate_model
from src.model.saver import save_model

def main():

    # Cargar los datos
    heart_disease = load_data(file_path = "data/raw/heart.csv")

    # Preprocesar los datos
    processed_data, target = process_data(
                                  df=heart_disease,
                                  columns_to_impute=['trestbps', 'chol', 'thalach', 'oldpeak'],  # columnas que pueden tener NaN
                                  target_column='num'  # Cambio para coincidir con la columna objetivo del dataset
                                  )

    # Dividir los datos en conjuntos de entrenamiento y prueba
    X_train, X_test, y_train, y_test = split_data(processed_data, target_column='num')

    # Convertir 'y' en binario
    y_train_binary = (y_train > 0).astype(int)
    y_test_binary = (y_test > 0).astype(int)

    # Entrenar el modelo
    model = train_model(X_train=X_train, y_train=y_train_binary)


    # Evaluar el modelo
    accuracy, precision, recall, f1, auc = evaluate_model(model, test_data=X_test, y_test=y_test_binary)

    # Imprimir las métricas
    print(f"Accuracy: {accuracy:.2f}")
    print(f"Precision: {precision:.2f}")
    print(f"Recall: {recall:.2f}")
    print(f"F1: {f1:.2f}")
    print(f"AUC: {auc:.2f}")


    # Guardar el modelo
    save_model(model, model_path="models/trained_model")

if __name__ == "__main__":
    main()
src/model/evaluator.py
Para un problema de clasificación médica, una sola métrica de “accuracy” no alcanza —y puede incluso ser engañosa si las clases están desbalanceadas—. Por eso esta función calcula un conjunto más completo: precisión (de los que el modelo marcó como enfermos, cuántos lo eran realmente), recall (de los que realmente estaban enfermos, cuántos detectó el modelo — clave en salud, donde un falso negativo es más costoso que un falso positivo), F1 (el balance entre ambas) y AUC-ROC (qué tan bien el modelo distingue entre las dos clases en general, independientemente del umbral de decisión elegido).
from sklearn.metrics import accuracy_score, precision_score, recall_score, f1_score, roc_auc_score
import xgboost
import pandas as pd

def evaluate_model(model: xgboost.sklearn.XGBClassifier, test_data: pd.DataFrame, y_test: pd.Series) -> tuple[float, float, float, float, float]:
    """
    Función para evaluar el modelo

    Args:
        model (xgboost.sklearn.XGBClassifier): Modelo a evaluar
        test_data (pd.DataFrame): Datos de prueba
        y_test (pd.Series): Etiquetas de prueba

    Returns:
        tuple[float, float, float, float, float]: Accuracy, Precision, Recall, F1, AUC
    """
    y_pred = model.predict(test_data)
    y_prob = model.predict_proba(test_data)[:, 1]

    accuracy = accuracy_score(y_test, y_pred)
    precision = precision_score(y_test, y_pred)
    recall = recall_score(y_test, y_pred)
    f1 = f1_score(y_test, y_pred)
    auc = roc_auc_score(y_test, y_prob)

    return accuracy, precision, recall, f1, auc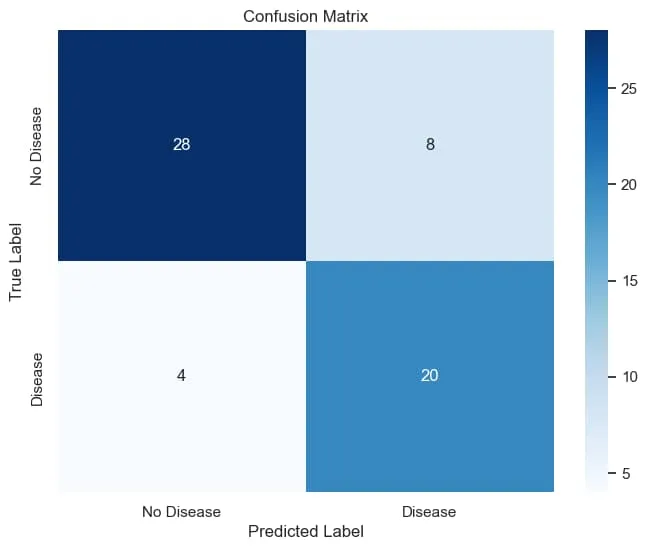
src/model/saver.py
Un detalle simple pero que denota buena práctica de MLOps: en vez de sobrescribir siempre el mismo archivo de modelo, esta función le agrega la fecha actual al nombre del archivo (_YYYY-MM-DD.joblib). Esto da versionado automático sin necesidad de una herramienta externa — cada vez que se reentrena el modelo con datos nuevos, queda un registro histórico de qué modelo se generó cuándo, útil tanto para trazabilidad como para poder comparar o revertir a una versión anterior si una nueva resulta peor.
from datetime import datetime
import joblib
import xgboost

def save_model(model: xgboost.sklearn.XGBClassifier, model_path: str) -> None:
    """
    Guarda el modelo en un archivo usando joblib.

    Args:
        model (xgboost.sklearn.XGBClassifier): Modelo a guardar.
        model_path (str): Ruta donde guardar el modelo (sin extensión).
    """
    current_date = datetime.now().strftime("%Y-%m-%d")
    full_path = f"{model_path}_{current_date}.joblib"
    joblib.dump(model, full_path)
    print(f"Modelo guardado en {full_path}")
src/model/trainer.py
El entrenamiento usa XGBoost, un modelo de gradient boosting sobre árboles, muy usado en datos tabulares por su buen desempeño con relativamente poco tuning. Los hiperparámetros por defecto acá son conservadores a propósito: max_depth=2 mantiene los árboles poco profundos (reduciendo el riesgo de overfitting en un dataset relativamente chico, como suele ser el caso en datasets clínicos), y learning_rate=0.1 con n_estimators=300 busca un aprendizaje gradual y estable en vez de ajustes bruscos. Que la función acepte un diccionario params opcional es lo que permite, más adelante, hacer búsqueda de hiperparámetros (grid search, optuna, etc.) sin tener que tocar el código del entrenador.
import xgboost as xgb
import pandas as pd

def train_model(X_train: pd.DataFrame, y_train: pd.Series, params: dict = None) -> xgb.sklearn.XGBClassifier:
    """
    Función para entrenar el modelo

    Args:
        X_train (pd.DataFrame): Dataframe con las variables independientes
        y_train (pd.Series): Serie con la variable objetivo
        params (dict, optional): Diccionario con los parámetros del modelo. Defaults to None.

    Returns:
        xgboost.sklearn.XGBClassifier: Modelo entrenado
    """
    if params is None:
        params = {'objective': 'binary:logistic',
                  'eval_metric': 'logloss',
                  'n_estimators': 300,
                  'max_depth': 2,
                  'learning_rate': 0.1,
                  'random_state': 42}

    model = xgb.XGBClassifier(**params)
    model.fit(X_train, y_train)

    return model