RAG LLM's - Economist
Aplicación de IA con base vectorial y modelo LLM para responder consultas sobre deuda histórica
Tecnologías
Descripción
Sistema de inteligencia artificial para consultas económicas:
-
Vectorización semántica de registros históricos de deuda
-
Base de datos vectorial con búsqueda por similitud
-
Interfaz CLI de preguntas económicas
-
Motor LLM para respuestas guiadas por contexto
-
Almacenamiento eficiente con Chroma DB
-
Embeddings generados por Ollama
-
Implementación robusta con LangChain y uv
-
Compatible con múltiples modelos LLM
Detalles Técnicos
Vectorización con Chroma
El primer paso de cualquier sistema RAG (Retrieval-Augmented Generation) es convertir los datos crudos en algo que un modelo de lenguaje pueda “buscar” por significado, no solo por texto exacto. Acá tomo los registros históricos de deuda desde un CSV y, en vez de dejarlos como filas sueltas de una tabla, los transformo en oraciones en lenguaje natural (ej. “En [fecha], el saldo era X, con desembolsos de Y y pagos de Z”). Esto es clave: un LLM entiende mucho mejor una oración descriptiva que una fila tabular aislada, y esa oración es la que después se va a comparar semánticamente contra las preguntas del usuario.
Cada registro se guarda como un Document de LangChain, con su fecha como metadato (útil para filtrar o rastrear la fuente de una respuesta más adelante). Después, uso OllamaEmbeddings con el modelo mxbai-embed-large para convertir cada documento en un vector numérico que captura su significado, y esos vectores se almacenan en Chroma, una base de datos vectorial local. Todo esto corre en local vía Ollama, sin depender de una API externa de pago — algo relevante si el objetivo es un sistema económico, reproducible y sin costos recurrentes de inferencia.
import pandas as pd
from langchain.vectorstores import Chroma
from langchain.embeddings import OllamaEmbeddings
from langchain_core.documents import Document

# Leer archivo CSV con datos de deuda
df = pd.read_csv("deuda.csv")

# Convertir registros en documentos enriquecidos
docs = []
for _, row in df.iterrows():
    metadata = {"fecha": row["Fecha"]}
    contenido = f"En {row['Fecha']}, el saldo era {row['Saldo']}, con desembolsos de {row['Desembolsos']} y pagos de {row['Pagos']}"
    doc = Document(page_content=contenido, metadata=metadata)
    docs.append(doc)

# Crear embeddings y almacenar en base vectorial
embedding = OllamaEmbeddings(model="mxbai-embed-large")
chroma_db = Chroma.from_documents(docs, embedding, persist_directory="chrome_langchain_db_deuda")

# Guardar base de datos
chroma_db.persist()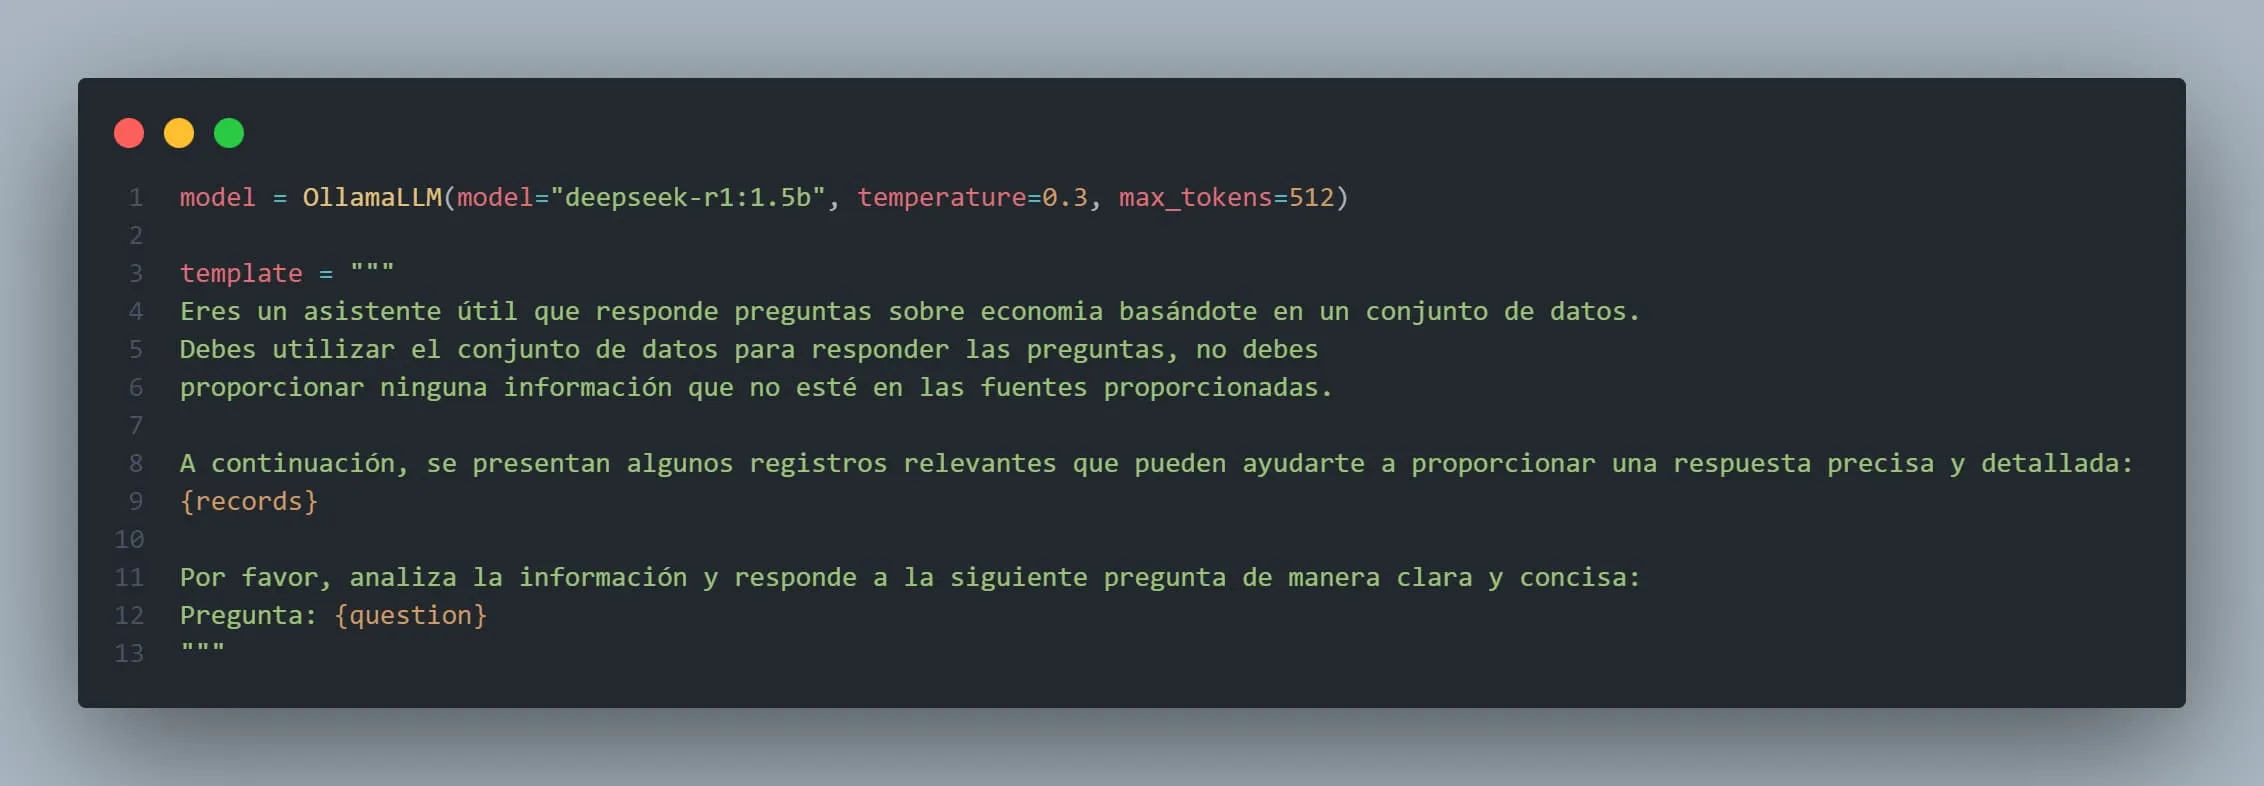
Interfaz de Consulta con LLM
Esta es la parte de “generación aumentada por recuperación” propiamente dicha. Cuando el usuario escribe una pregunta económica por consola, el retriever busca en la base vectorial de Chroma los documentos más similares semánticamente a esa pregunta (no por palabras clave, sino por cercanía de significado en el espacio de embeddings), y esos registros recuperados se insertan como contexto ({records}) dentro de un prompt template.
El prompt está diseñado deliberadamente para restringir al modelo a responder solo con la información recuperada, sin inventar datos que no estén en las fuentes — un control importante para reducir alucinaciones, sobre todo tratándose de cifras económicas donde precisión y trazabilidad importan. Como modelo uso deepseek-r1:1.5b corriendo localmente vía Ollama, con temperature=0.3 para priorizar respuestas consistentes y poco creativas (lo cual tiene sentido acá: no queremos que el modelo “interprete” libremente una serie de deuda). El resultado es un loop de CLI simple donde cada pregunta dispara: búsqueda semántica → armado de contexto → generación de respuesta.
from langchain_ollama.llms import OllamaLLM
from langchain_core.prompts import ChatPromptTemplate
from vector import retriever

# Configurar modelo LLM
model = OllamaLLM(model="deepseek-r1:1.5b", temperature=0.3, max_tokens=512)

# Plantilla de prompt con registros recuperados
template = """
Eres un asistente útil que responde preguntas sobre economia basándote en un conjunto de datos.
Debes utilizar el conjunto de datos para responder las preguntas, no debes
proporcionar ninguna información que no esté en las fuentes proporcionadas.

A continuación, se presentan algunos registros relevantes que pueden ayudarte a proporcionar una respuesta precisa y detallada:
{records}

Por favor, analiza la información y responde a la siguiente pregunta de manera clara y concisa:
Pregunta: {question}
"""
prompt = ChatPromptTemplate.from_template(template)
chain = prompt | model

# Loop de interacción CLI
while True:
    print("\n\n-------------------------------")
    query = input("Escribe tu pregunta económica (o 'q' para salir): ")
    if query == "q":
        break
    docs = retriever.get_relevant_documents(query)
    context = "\n".join([doc.page_content for doc in docs])
    respuesta = chain.invoke({"question": query, "records": context})
    print("\nRespuesta generada:\n", respuesta)