La ilusión del 95 %: qué dice (y qué no) tu intervalo de confianza
Por qué el 95 % describe el método, no tu parámetro. Simulaciones de cobertura, el dilema del churn, Jeffreys–Lindley y prácticas para no engañarse.
Publicado el 12 de septiembre de 2026
Etiquetas
El error más frecuente: qué significa realmente el 95%
La escena típica
En un panel de control de tests A/B: la variante nueva subió 0.4 puntos porcentuales en retención, el intervalo no cruza cero, y alguien pregunta si eso implica un 95% de confianza en que la nueva versión sea mejor.
La respuesta que casi nadie se atreve a dar es no.
De dónde vino la idea
Jerzy Neyman revolucionó la inferencia estadística entre 1934 y 1937 planteándose una pregunta distinta. En lugar de preguntar dónde estaba el parámetro desconocido, preguntó qué tan seguido su método acertaba a capturarlo. Su respuesta: construir reglas de estimación tales que, si se aplicaban una y otra vez sobre nuevas muestras, el procedimiento atrapara el valor verdadero el 95% de las veces.
Esa es la definición completa: no habla del intervalo individual que ves en pantalla. Habla del comportamiento del procedimiento en el largo plazo.
La máquina detrás del número
El teorema central del límite es la maquinaria. Si es la media de observaciones independientes de una distribución con media y desviación , entonces para muestras grandes:
Reescribiendo de forma que quede al centro:
Todo lo aleatorio en esas dos líneas es , no . Una vez que introduces tus datos reales, el intervalo se convierte en números fijos: contiene el parámetro o no. El 95% describe la máquina que construyó el intervalo, no el intervalo mismo.
La verificación por simulación
import numpy as np
import matplotlib.pyplot as plt

# True conversion rate
p_true = 0.015
n = 20_000
n_sims = 100

np.random.seed(42)
covered = []
intervals = []

for _ in range(n_sims):
    x = np.random.binomial(n, p_true)
    p_hat = x / n
    se = np.sqrt(p_hat * (1 - p_hat) / n)
    lo = p_hat - 1.96 * se
    hi = p_hat + 1.96 * se
    intervals.append((lo, hi))
    covered.append(lo <= p_true <= hi)

# Plot first 40 intervals
fig, ax = plt.subplots(figsize=(8, 5))
for i, (lo, hi) in enumerate(intervals[:40]):
    color = "tab:blue" if covered[i] else "tab:red"
    ax.plot([lo, hi], [i, i], color=color, alpha=0.8)

ax.axvline(p_true, color="black", linestyle="--", label=f"True p = {p_true:.3f}")
ax.set_yticks([])
ax.set_xlabel("95% confidence interval for p")
ax.set_title("Coverage simulation: ~95% of intervals contain the true p")
ax.legend()
plt.tight_layout()
plt.show()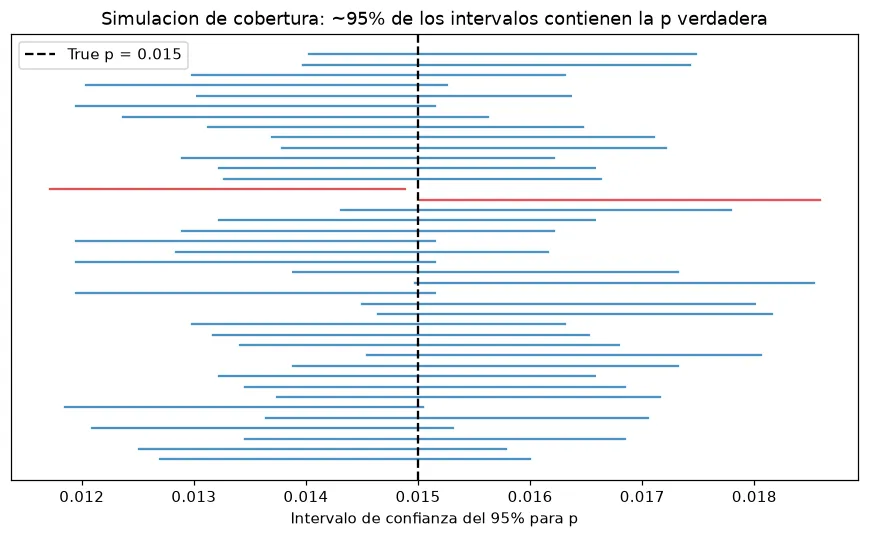
Por qué importa esta distinción
Leer un intervalo como una aseveración sobre el parámetro es responder una pregunta que el método nunca hizo. Quien quiere una probabilidad directa sobre el efecto necesita un marco que declare explícitamente sus supuestos iniciales: el bayesiano.
Intervalos creíbles: cuando preguntas distintas piden respuestas distintas
Cuál es la pregunta bayesiana
El intervalo de confianza pregunta: ¿este procedimiento funciona de manera confiable?. El intervalo creíble pregunta lo que la mayoría tiene en mente: dados mis conocimientos previos y lo que acabo de observar, ¿cuál es la probabilidad de cada rango del parámetro?.
Para contestar eso hay un costo: el parámetro debe modelarse como una variable aleatoria con una distribución previa, lo que obliga a escribir una creencia inicial antes de mirar los datos.
El mecanismo bayesiano
La fórmula de Bayes combina el prior (creencia previa sobre el parámetro) con la verosimilitud (información que traen los datos):
El posterior es la distribución actualizada del parámetro. Ya no es arbitraria (depende del dato) pero tampoco es única (depende del prior). El intervalo creíble al 95% es el rango donde ese posterior acumula 0.95 de su masa. Con él en mano, puedes afirmar: “hay un 94% de probabilidad de que el efecto sea positivo” — algo que el intervalo frecuentista nunca te permitió decir.
Lado a lado
| Aspecto | Intervalo de confianza | Intervalo creíble |
|---|---|---|
| Pregunta | ¿funciona el procedimiento de forma confiable? | ¿qué debo creer tras ver el dato? |
| Qué varía | el intervalo (entre muestreos) | el parámetro (bajo el posterior) |
| Requiere prior | no | sí |
| Significado del 95% | 95% de los intervalos construidos así atrapan el valor | 95% de masa posterior dentro del rango |
| Uniformidad | todos los analistas obtienen lo mismo | varía según el prior elegido |
Cómo el prior cambia la conclusión
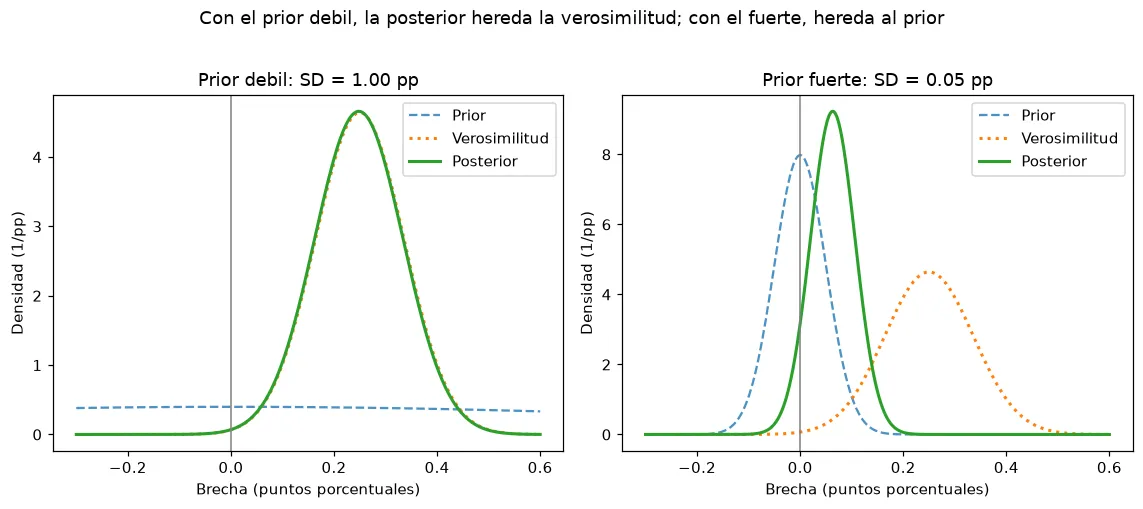
Code/prior_posterior_demo.py analiza el ejemplo de churn (brecha de 0.25 pp, SE = 0.086 pp) usando conjugación Normal–Normal: la precisión del posterior es la suma de precisiones, su media es un promedio ponderado.
- Prior débil
N(0, 1.00²): precisión 1 versus ~135 de los datos. El dato domina por completo. PosteriorN(0.248, 0.086²)con intervalo creíble [0.08, 0.42] pp. Idéntico al Wald. - Prior fuerte
N(0, 0.05²): precisión 400, que triplica la del dato. El posterior se jala hacia el prior. PosteriorN(0.063, 0.043²)con creíble [−0.02, 0.15] pp. Ahora incluye el cero.
Mismo experimento, mismo dato, dos conclusiones defendibles. La figura 02_priors_posteriors.png lo visualiza: a la izquierda el posterior calcando la verosimilitud; a la derecha, el posterior apretado hacia el prior.
Cuándo optar por cada uno
El intervalo creíble es natural cuando tienes información histórica confiable (métricas de períodos anteriores, capacidad demostrada, ensayos previos). Su objetivo es actualizar una creencia que va a guiar una decisión. El intervalo frecuentista es mejor cuando necesitas un estándar reproducible y verificable sin pedirle a nadie que declare un prior: piensa en auditorías de terceros o lanzamientos regulados.
El caso del churn: dos análisis sobre los mismos datos
El escenario
Una plataforma de suscripción registra abandono mensual. Históricamente, 1.50 puntos porcentuales. Tras un cambio de producto, 20.000 usuarios activos vieron 350 bajas: 1.75 pp. La brecha es +0.25 pp. La pregunta de negocio: ¿es real o ruido?
Lectura frecuentista
Se asume que la verdadera brecha es cero y se estima el ruido esperado bajo esa suposición:
Dividiendo la brecha observada por el error estándar: z = 0.25 / 0.086 ≈ 2.9, que corresponde a un p-valor bilateral cercano a 0.004.
El intervalo de confianza Wald es 0.25 ± 1.96·0.086 ≈ [0.08, 0.42] pp: completamente por encima de cero.
Veredicto: bajo este método, el cambio parece real. Hay que investigar.
Lectura bayesiana: primer escenario
Se toma la misma verosimilitud pero se añade un prior sobre la brecha. Usando conjugación Normal–Normal:
Prior débil δ ~ N(0, 1.00²) pp — “cualquier efecto entre −2 y +2 pp es compatible con lo que sé”:
No incluye cero. Coincide con el frecuentista: cuando el prior es vago, ambos dicen lo mismo.
Lectura bayesiana: segundo escenario
Prior fuerte δ ~ N(0, 0.05²) pp — “por el historial del producto, cambios de este tipo raramente superan algunas décimas. Cambios grandes son improbables”:
Ahora sí contiene cero: el mismo experimento, con otro supuesto inicial declarado, resulta inconcluyente.
Resumen de los tres veredictos
| Análisis | Intervalo al 95% (pp) | ¿Contiene 0? | Conclusión |
|---|---|---|---|
| Frecuentista (Wald) | [0.08, 0.42] | No | efecto presente |
| Bayesiano, prior débil | [0.08, 0.42] | No | efecto probable |
| Bayesiano, prior fuerte | [−0.02, 0.15] | Sí | sin conclusión |
Los mismos 20.000 usuarios, los mismos 350 eventos. Lo que cambia es la apuesta previa sobre el tamaño de los efectos. Cuando dos marcos razonables divergen, ese desacuerdo no es un fallo: es información que fuerza a elegir un prior de forma explícita en lugar de ocultarlo bajo la aparente objetividad de un umbral fijo.
Jeffreys–Lindley: por qué muestras enormes pueden engañarte
El fenómeno en una línea
El error estándar de una proporción decae como :
Por eso el estadístico para una brecha absoluta fija crece como . Nada requiere que el efecto sea importante; basta que no sea exactamente cero y que hayas recolectado bastantes observaciones.
Observando la curva
Code/prior_posterior_demo.py dibuja el z de una brecha fija de 0.25 pp contra tamaño muestral desde 10³ hasta 10⁶ en escala logarítmica:
Valores de la réplica:
| n | z para brecha de 0.25 pp |
|---|---|
| 1.000 | 0.65 — ruido puro |
| ~9.100 | 1.96 — toca el umbral “significativo” |
| 20.000 | 2.91 — el caso de churn |
| 100.000 | 6.51 |
| 1.000.000 | 20.57 — “con toda seguridad” |
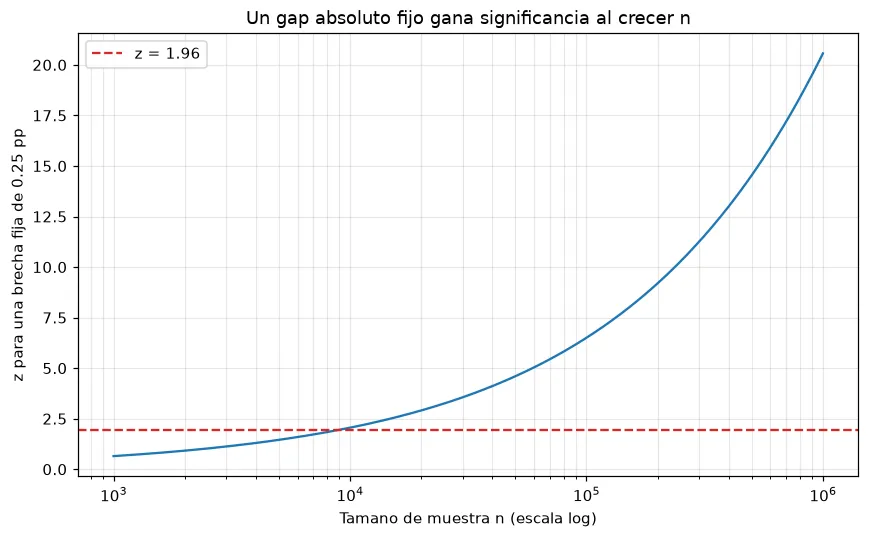
Con apenas 9.000 usuarios una diferencia económicamente trivial cruza el umbral de significancia. Con un millón, cualquier artefacto del experimento — sesgo mínimo en la asignación, estacionalidad no controlada — aparecerá como un descubrimiento irrefutable. La significancia estadística ya no distingue entre “hay efecto” y “hay datos suficientes para detectar lo que sea”.
El significado de la paradoja
Harold Jeffreys y Dennis Lindley observaron desde perspectivas distintas el mismo patrón: frente a un p-valor minúsculo en una muestra descomunal, la hipótesis nula puede seguir siendo la explicación más plausible bajo un prior razonable. A medida que crece n, aumenta la precisión del dato, pero si el prior asigna masa alta a efectos diminutos (lo cual es sensato cuando los cambios pequeños casi nunca mueven métricas), el posterior se mantiene cerca del prior y el “hallazgo detectado” no persuade. El test grita; la actualización de creencias susurra.
La salida práctica
La confusión central es equiparar “detectable” con “material”. Son preguntas distintas:
- Magnitud: ¿la estimación y su intervalo son lo suficientemente grandes para mover una decisión de negocio?
- Fiabilidad: ¿el experimento diferencia ese umbral del ruido?
Al crecer n, fija un umbral material de antemano y exígelo con más rigor, no menos.
Frequentista o bayesiano: marcos para audiencias distintas
No es un debate ideológico
Ambos son internamente consistentes. Contestan preguntas diferentes. La elección razonable depende de cuál pregunta necesitas responder y de qué puedas justificar ante tu audiencia.
Lo que hace bien el marco frequentist
- Reproducibilidad sin supuestos. Dos analistas con los mismos datos obtienen el mismo número. Para auditorías y lanzamientos regulados, esa propiedad es un requisito.
- Garantía de procedimiento. El 95% (o el 1%) se refiere al comportamiento a largo plazo. Bien usado, permite afirmar: “si este proceso se repite, falsea menos del 5% de las veces”.
- Sus límites. No habla de probabilidades de hipótesis. Su umbral fijo degenera con muestras enormes. Un diseño que solo exige “p < 0.05” autoriza decisiones sobre diferencias triviales.
Lo que hace bien el marco bayesiano
- Actualización de creencias con evidencia. Entrega lo que el interesado pregunta: probabilidad de que el efecto supere un umbral, rango plausible del parámetro, riesgo de decidir mal.
- Supuestos explícitos. El prior es una ecuación que se puede discutir, someter a análisis de sensibilidad, reemplazar cuando hay nueva información.
- Sus límites. Dos analistas con priors distintos obtienen intervalos distintos sobre el mismo dato. Con muestras muy pequeñas el prior domina. Con muestras enormes y modelos mal especificados, el posterior hereda el sesgo del modelo.
Tabla de decisión para equipos de producto
| Situación | Usar | Por qué |
|---|---|---|
| Puerta de release auditada por terceros | Frequentist | reproducibilidad sin pedirle priors a nadie |
| Información histórica sólida (métricas previas, modelos base) | Bayesiano | la información previa ya existe; usarla explícitamente mejora |
| Comunicar riesgo al negocio (“probabilidad de no lograr meta”) | Bayesiano | el negocio pregunta probabilidades, no comportamientos de procedimientos |
| Monitoreo continuo con decisiones secuenciales | Frequentist o Bayesiano con modelo de decisión | controlar la tasa de falsos positivos del procedimiento |
| Desacuerdo entre ambas lecturas | Investigar ambas | el desacuerdo señala un supuesto o un dato cuestionable |
Síntesis
Elegir un marco es, en los hechos, elegir qué pregunta estás dispuesto a justificar ante el equipo. Los números de los reportes muestran por qué: un mismo experimento admite “rechazo de hipótesis nula”, “el efecto probablemente existe” y “no alcanza conclusión”. El 95% del enunciado inicial no cubre ninguno de esos veredictos por sí solo.
Cuatro prácticas antes de reportar un intervalo
1. Escribe el umbral de decisión antes de ver los datos
Antes de lanzar el test, declara qué resultado cambiaría tu decisión — en magnitud y dirección, no en asteriscos. Una brecha de 0.05 pp rara vez justifica mover un roadmap aunque parezca “significativa” con 100.000 usuarios.
2. Frente a un rechazo con muestra grande, verifica la materialidad
La curva de Jeffreys–Lindley mostró que z cruza 1.96 con ~9.000 usuarios para una brecha de 0.25 pp y llega a ~20 con un millón. Significancia con muestras enormes casi siempre significa “no exactamente cero”, nunca “lo suficientemente grande”.
3. Cuando frecuentista y bayesiano discrepan, investiga
Mismo experimento, tres conclusiones. Un desacuerdo así tiene tres lecturas posibles:
- el prior estaba mal calibrado (ignoraba efectos reales de ese tamaño);
- hay un problema de datos (sesgo, mezcla de poblaciones, estacionalidad);
- el régimen cambió: lo que el prior representaba ya no describe el producto.
No elijas el resultado que te conviene y silencies el otro.
4. Etiqueta qué pregunta responde cada número
“IC 95%” e “intervalo creíble 95%” son criaturas distintas. Quien lee tu informe debe saber si el número describe un comportamiento de procedimiento a largo plazo o una probabilidad sobre el parámetro bajo un prior declarado.
La ilusión del título no es que el 95% sea falso — la simulación lo verificó (95 de 100 intervalos capturaron el valor). La ilusión es creer que ese número responde la pregunta que tu negocio está haciendo. Conocer el procedimiento a fondo — y poder replicarlo — es la mejor defensa contra ese error.